GPU Nvidia cũ bất ngờ tăng gấp đôi hiệu năng AI nhờ màn "tác động vật lý" từ các pháp sư
Các bản mod mới đã gỡ bỏ giới hạn phần mềm trên GPU NVIDIA GeForce RTX 30 và 40 series, giúp tăng gấp đôi hiệu suất xử lý AI và mô hình ngôn ngữ.
Cộng đồng tối ưu phần cứng vừa ghi nhận bước tiến đáng chú ý khi các bản chỉnh sửa phần mềm có thể gỡ bỏ giới hạn tính toán trên các dòng card đồ họa NVIDIA GeForce RTX. Việc can thiệp này giúp khai thác tối đa năng lực xử lý ma trận của Nhân Tensor, mang lại hiệu suất vượt trội cho các tác vụ trí tuệ nhân tạo ngay trên thiết bị cá nhân.
Mở khóa tiềm năng tính toán trên kiến trúc Ampere và Ada Lovelace
Thực tế các dòng card đồ họa thương mại GeForce RTX 30 series và RTX 40 series của NVIDIA đều sử dụng chung thiết kế nhân silicon với các dòng GPU chuyên dụng dành cho máy trạm. Tuy nhiên, nhà sản xuất đã giới hạn tốc độ phát lệnh tính toán thông qua tầng firmware để phân biệt phân khúc sản phẩm. Việc loại bỏ rào cản này giúp các GPU phổ thông đạt được tốc độ xử lý tương đương với những thiết bị chuyên dụng cao cấp.
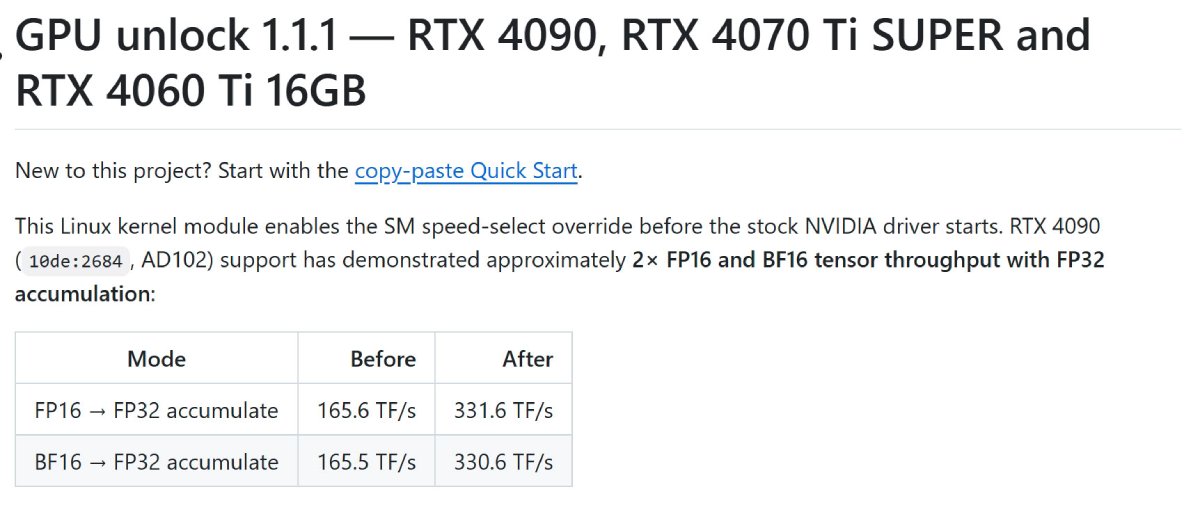
Đối với thế hệ GeForce RTX 30 series dựa trên kiến trúc Ampere, giải pháp mở khóa cho phép tăng gấp đôi tốc độ phát lệnh của các phép tính FP/BF16 FMA sang FP32. Giải pháp này áp dụng cho các dòng chip GA102, GA103, GA104 và GA106. Kết quả thử nghiệm ghi nhận mẫu card GeForce RTX 3090 Ti đạt tốc độ nhân ma trận trong định dạng BF16 nhanh hơn tới 80%, một yếu tố then chốt đối với việc vận hành các mạng thần kinh nhân tạo.
Tăng gấp đôi băng thông Tensor Core trên dòng RTX 40 series
Bước đột phá tiếp theo xuất hiện trên dòng GeForce RTX 40 series sử dụng kiến trúc Ada Lovelace với các mã chip AD102, AD103 và AD106. Thử nghiệm trên GeForce RTX 4090 cho thấy hiệu suất Tensor FP16 và BF16 đi kèm tích lũy FP32 tăng từ mức 165.6 TeraFLOPS lên tới 331.6 TeraFLOPS. Mức hiệu năng này tiệm cận với dòng card đồ họa máy trạm cao cấp NVIDIA RTX 6000 Ada Lovelace.
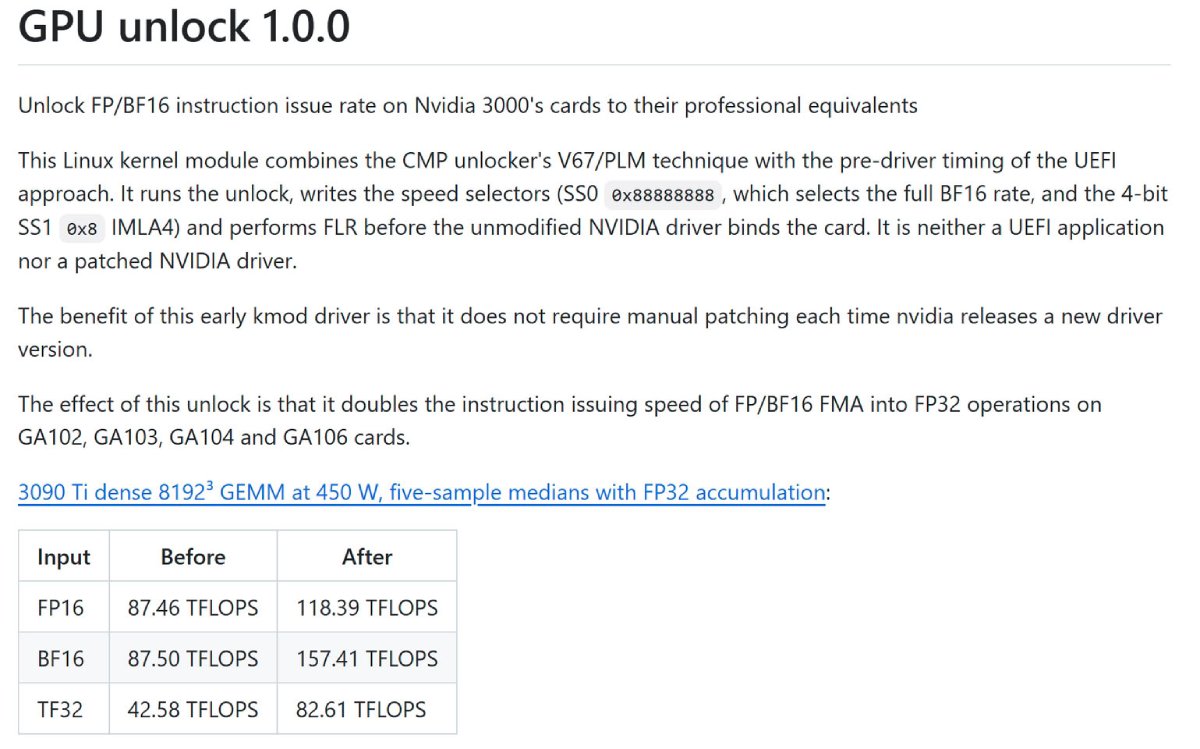
Sự gia tăng chỉ số này cho thấy NVIDIA đã thiết lập giới hạn nhân tạo đối với các phép tính nhân và tích lũy ma trận trên nhân AD102. Điều này ảnh hưởng trực tiếp đến tốc độ xử lý các mô hình ngôn ngữ lớn (LLM). Việc gỡ bỏ rào cản giúp người dùng cá nhân tận dụng được tối đa sức mạnh phần cứng có sẵn cho các tác vụ tính toán chuyên sâu.
Cơ chế vận hành và những đánh đổi về mặt kỹ thuật
Cả hai phương pháp mở khóa trên dòng Ampere và Ada Lovelace đều vượt qua được cơ chế kiểm tra của trình điều khiển NVIDIA và đè lên quy trình PCIe Function Level Reset (FLR). Hệ thống vẫn vận hành bình thường với trình điều khiển chính thức và vượt qua các bài kiểm tra tiêu chuẩn CUDA. Mức tiêu thụ điện năng tổng thể của card không thay đổi, ví dụ như mức TGP 450 W trên các mẫu GA102 và AD102 vẫn được giữ nguyên trước và sau khi can thiệp.
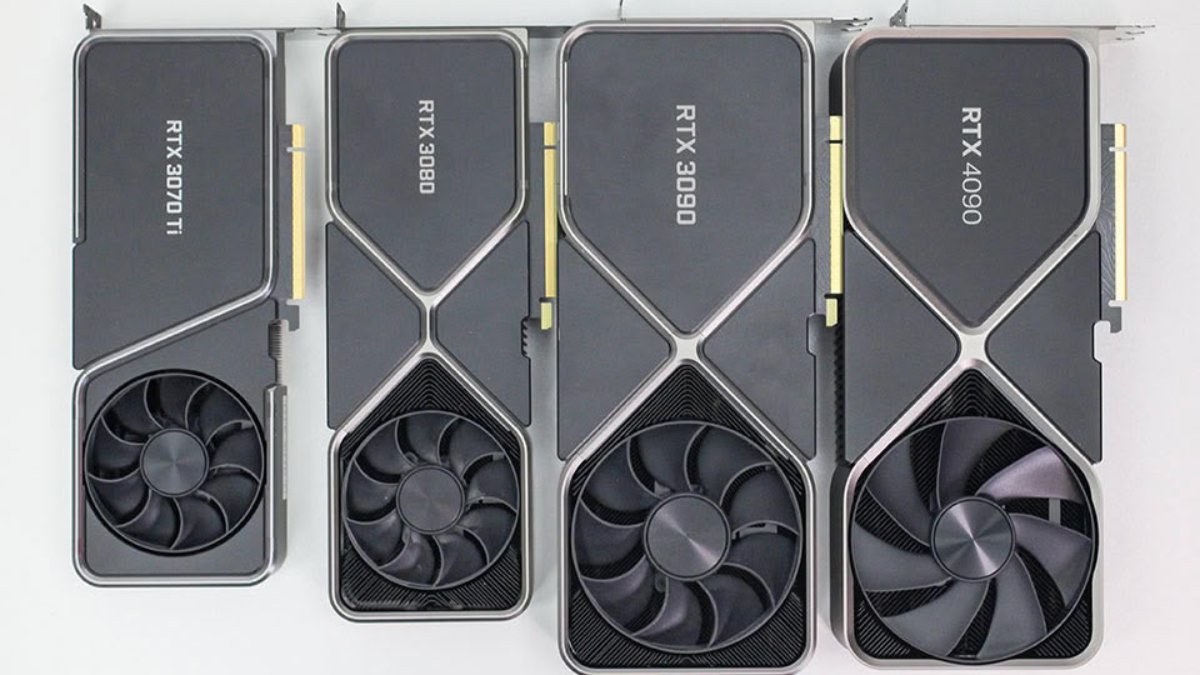
Đối với người dùng chạy các mô hình ngôn ngữ lớn cục bộ, việc gia tăng sức mạnh tính toán giúp cải thiện đáng kể tốc độ xử lý token trong cả hai giai đoạn prefill và decode.
Mặc dù mang lại hiệu năng cao hơn, giải pháp này yêu cầu kích hoạt ngay từ quá trình khởi động máy để liên kết trước khi trình điều khiển NVIDIA can thiệp vào nhân hệ điều hành. Đồng thời, mọi hành vi can thiệp sâu vào firmware GPU đều sẽ làm mất hiệu lực bảo hành chính thức từ nhà sản xuất. Bạn đừng quên hãy thường xuyên ghé thăm trang Sforum để được cập nhật những thông tin công nghệ mới nhất nhé.
Nguồn: Gizmochina
CellphoneS hiện đang bán nhiều laptop chất lượng với giá hấp dẫn mà bạn có thể tham khảo thêm ở danh sách bên dưới:
[Product_Listing categoryid="380" propertyid="" customlink="https://cellphones.com.vn/laptop.html" title="Danh sách Laptop đang được quan tâm nhiều tại CellphoneS"]
Xem thêm:

Bình luận (0)